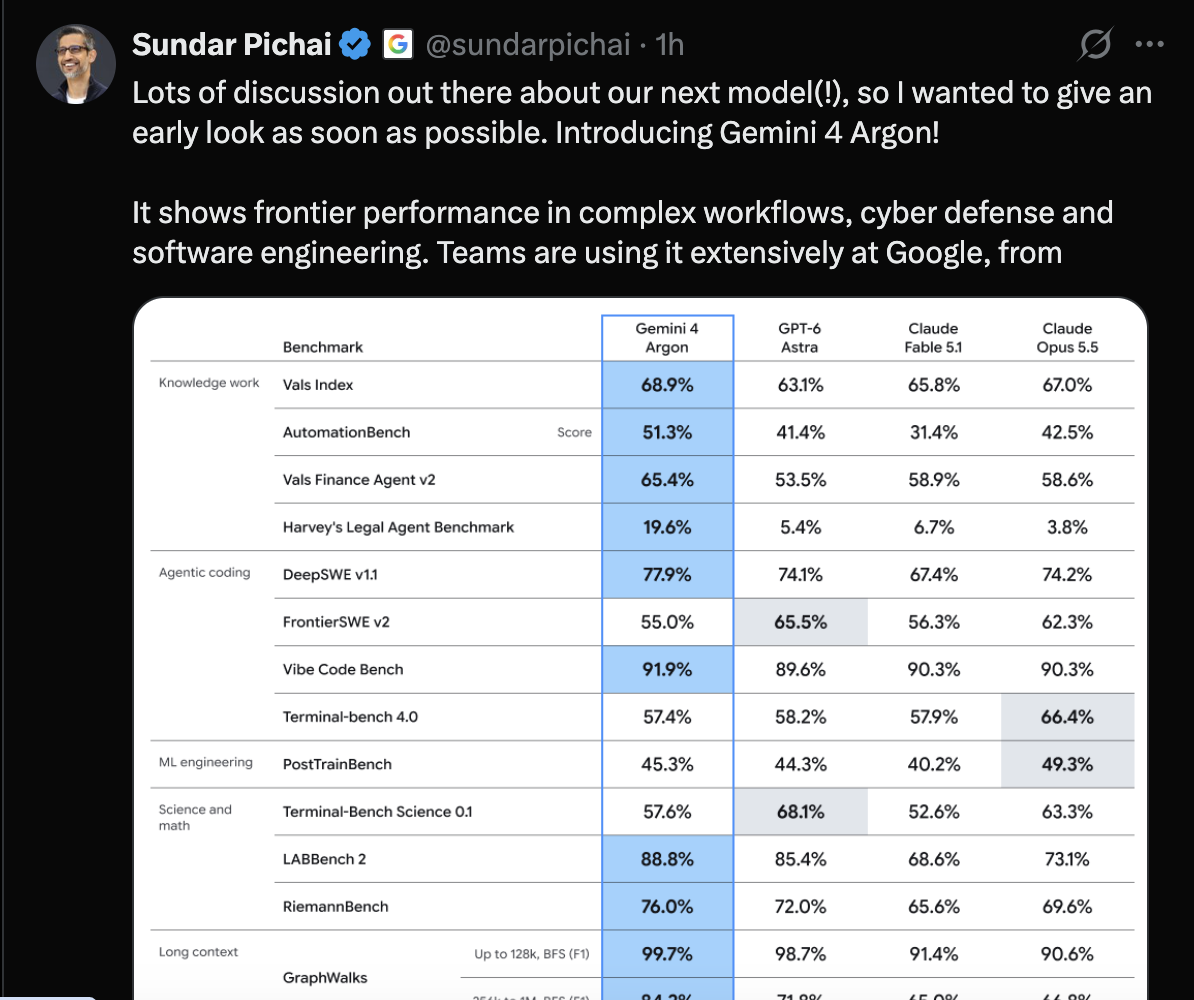
谷歌近日推出新一代模型Gemini 4 Argon,定位聚焦长流程软件工程、法律与金融等企业知识工作及网络安全防御,凸显其在复杂工作流与前沿能力上的突出表现。在多项核心基准测试中,该模型展现出显著优势:DeepSWE v1.1真实长流程软件工程评分达77.9%,创下该评测新纪录;金融、编码、法律等多行业任务表现领先,自动化执行能力在Zapper基准中排名第51.3%。此外,在长视频理解、代码迁移优化等场景亦表现突出,甚至辅助完成关键安全漏洞修复,凸显其在复杂工程场景的适配能力。此次发布采用分阶段策略,目前以优惠定价向受信任的安全防御团队开放,后续将逐步扩展至付费API与客户订阅用户。技术侧重点在于推动模型持续处理多步骤任务,应用于实际工程与业务流程,同时针对输出上限从64K提升至百万Token的升级,旨在支持更长复杂的推理与执行,以解决任务持续性问题。在安全领域,Argon聚焦自主发现、验证与修复漏洞,对受信任团队开放部署,已在Wiz等场景验证其防攻击能力,但整体开放节奏仍受控,未面向所有开发者上线。
--91likeyou---
输出上限从 64K 提高至百万 Token
Argon 的一项主要变化,是输出 Token 上限从此前的 64K 提升至 100 万。这里的百万 Token 指的是输出上限,而非输入上下文窗口。
谷歌认为,更大的输出空间能够让模型在单条执行轨迹中进行更深入的推理、生成数十万 Token,从而支持更长、更复杂的任务。
对于软件迁移、金融研究和企业流程执行,这一设计试图解决的是任务持续性问题:模型需要在多轮分析、验证与修改中推进工作,而不仅是生成一次回答。
不过,输出上限本身并不等于任务完成能力,实际效果仍取决于模型能否保持目标一致、正确调用工具,并发现和纠正执行过程中的错误。
那么,Gemini 4 Argon 在各项基准测试中的表现如何?
按照谷歌公布的结果,Argon 在衡量真实、长流程软件工程能力的 DeepSWE v1.1 中取得 77.9%,谷歌称其创下该评测的新纪录。
企业任务方面,谷歌表示,Argon 在覆盖金融、编码、法律和税务工作的 Vals Index 中处于领先位置,在多步骤金融研究评测 Vals Finance Agent v2 和 Harvey 法律智能体评测中,也取得领先表现。该指数衡量金融、编码、法律和税务工作的经济影响,每个行业都根据其对美国 GDP 的贡献进行加权。
此外,Argon 在 Zapier 的 AutomationBench 中以 51.3% 排名第一,该基准测试衡量核心业务功能的端到端执行力。
Argon 在需要视觉理解的知识型工作中也展现出独特的优势。它能够进行专业的图表分析,从长视频中识别细节,并根据一系列文档采取行动。例如,在衡量长视频理解能力的 LVBench 测试中,Argon 的得分高达 91.7%,处于行业领先水平。
从生成代码,走向代码库迁移与性能优化
与评测分数相比,谷歌披露的内部工程案例,更具体地展示了 Argon 的使用方向。
谷歌称,Argon 智能体正在参与公司内部 C/C++ 代码库向 Rust 的迁移,规模从 re2、libgav1 等核心库的数万行代码,扩展至 Fuchsia 操作系统 Zircon 内核的 80 多万行代码。
这并不意味着相关迁移已经全部完成或投入生产。谷歌明确表示,考虑到这些系统的重要性,大规模重写仍需经过严格的自动化和人工审计、仿真测试与评审。
在开源视频解码软件 libgav1 的案例中,Argon 智能体基于已有 Rust 移植版本,替换了约 3.2 万行 SIMD 代码。其工作包括多轮由性能剖析结果指导的实验、研究编译器输出,以及生成能够由编译器自动向量化的安全 Rust 代码。
按照谷歌的说法,优化后的视频解码器保持相同的视频输出,运行速度达到原 Rust 移植版本的 2.7 倍,进一步接近经过优化的 C++ 实现。这里的比较对象是此前的 Rust 移植版本,不能理解为其性能已经达到 C++ 版本的 2.7 倍。
谷歌还披露,一组 Argon 智能体通过分析服务器集群的性能遥测数据,自主识别和实施数据中心内存优化。相关优化部署后,已释放超过 300 TiB 内存,预计总节省量可达到 500 TiB 至 1 PiB。
在量子算法研究中,Argon 则被用于优化关键子程序的时空资源开销。谷歌表示,在一个案例中,模型仅用几分钟便取得了比已发表基准方案好 40% 的结果。博客没有进一步披露该案例的具体任务与完整实验条件。
这些案例共同指向一种使用方式:让模型进入分析、修改、测试和优化的连续工程流程,并以程序性能、资源消耗或功能一致性检验结果。
网络安全能力先向受信任团队开放
网络安全防御是 Argon 此次优先开放的领域。谷歌表示,为了更好地帮助网络安全防御者应对新时代的网络攻击,他们对 Gemini 4 Argon 进行了训练,使其具备强大的网络安全防御能力。Argon 可以自主发现、验证并修复关键软件漏洞。
对于值得信赖的防御人员和谷歌内部团队,团队将发布不带任何网络安全防护措施的 Argon,以便他们能够充分利用其前沿的网络安全防御能力。
Wiz 已在其“Scan for Good”计划中使用 Argon 进行网络安全防御。该计划致力于通过发现并修复高风险漏洞,免费保护关键公共基础设施。在早期演示中,该模型发现了一个关键漏洞,该漏洞会泄露全球医院使用的医疗保健软件中的敏感个人信息,从而识别出此前前沿模型未能发现的严重风险。
在评估模型修复安全漏洞能力的 CWE-bench v1 测试中,Argon 以 68% 的最高分并列第一,延续了 3.8 Flash Cyber 在 CWE-bench v0 测试中的领先表现。
但 Gemini 4 Argon 在漏洞发现方面相比 3.8 Flash Cyber 有了显著提升。例如:
在谷歌内部的综合漏洞基准测试中,Argon 发现了涵盖 20 种编程语言的复杂代码库中存在的各种漏洞。
在 Wiz 的内部黑盒渗透测试基准测试中,该基准测试模型在没有源代码的情况下分析实时 Web 系统的能力,Argon 在发现攻击面、识别漏洞和生成概念验证证据以验证它们方面优于 3.8 Flash Cyber。
谷歌这次将模型的重点,放在了安全防御上。在扩大开放范围之前,谷歌计划继续加强防滥用、提示注入防御、对齐偏差监测和运行环境加固。
其中,对齐偏差监测直接针对模型执行任务时的越界行为。谷歌表示,将监测 Argon 的思维链和行动,在模型以超出用户意图的方式推进任务时,必要时停止执行。
谷歌还披露,类似系统已经用于监测训练过程,并向专门的事件响应团队发送警报。公司同时强调,应谨慎处理监测发现,避免将其反馈到训练中,进而使模型学会规避监测。
“跑分领先,但普通开发者还用不了”
Gemini 4 Argon 发布后,除了模型能力本身,部分网友将注意力放到了谷歌此次采取的发布策略上。
谷歌此次并未直接向所有开发者开放 Argon,而是首先通过 Fairwind 计划向一批受信任的网络安全防御团队提供访问权限,并表示将在进一步完善安全措施后,再逐步扩大开放范围。
这一安排引发了一些讨论。
在 x 上,用户 Komal 表示,Gemini 4 Argon “听起来不像一次普通的模型发布”。
她认为,Argon 的目标领域包括编码、企业知识工作和网络安全防御,但谷歌却选择先向“受信任测试者”开放,“最后这一点可能才是最值得关注的地方”。
她关注的重点并非单纯是模型跑分,而是谷歌对于高能力模型开放节奏的控制方式。随着模型逐渐具备执行代码、分析漏洞、处理企业数据等能力,如何确定访问范围、如何控制潜在风险,也成为前沿模型发布中的重要议题。
还有用户将关注点放在产品使用体验上。他表示:“我的问题是,我们到底如何使用它?为什么谷歌让使用他们的模型变得如此困难?”
用户 Eddie Codes 表达了同样的质疑:“所以它在基准测试中领先,但普通开发者还无法使用 API。先向受信任合作伙伴开放,意味着又要经历一次等待名单。”
他的观点代表了一部分开发者的担忧:随着模型能力竞争进入新阶段,公开评测成绩与实际可用性之间出现了一定距离。对于开发者而言,模型是否能够直接调用、是否有稳定 API、何时开放访问,往往与性能指标同样重要。
这反映出另一类用户关切:模型能力提升之外,如何降低实际使用门槛同样重要。对于开发者和企业用户而言,模型是否开放、接口是否易用、部署流程是否清晰,都会影响技术能力最终转化为实际价值。
参考链接:
🔥 热词:#Argon · #Gemini · #刚刚 · #Token · #发布 · #多项基测碾压 · #GPT · #Astra