Meta公司宣布,其首款专为训练排序和推荐模型优化的自研加速器MTIA 300已成功研发并开始量产。这一进展标志着Meta在自研芯片领域的进一步扩张,旨在通过专用化技术解决大语言模型训练中的通信瓶颈问题。与GPU相比,MTIA 300通过将网络和集合通信直接集成到芯片中,显著减少了AllReduce、AllToAll和AllGather操作的频率,从而有效降低了计算与通信之间的压力。此外,Meta还计划推出后续产品,以覆盖排序、推荐以及生成式AI等各类工作负载。
--91likeyou---
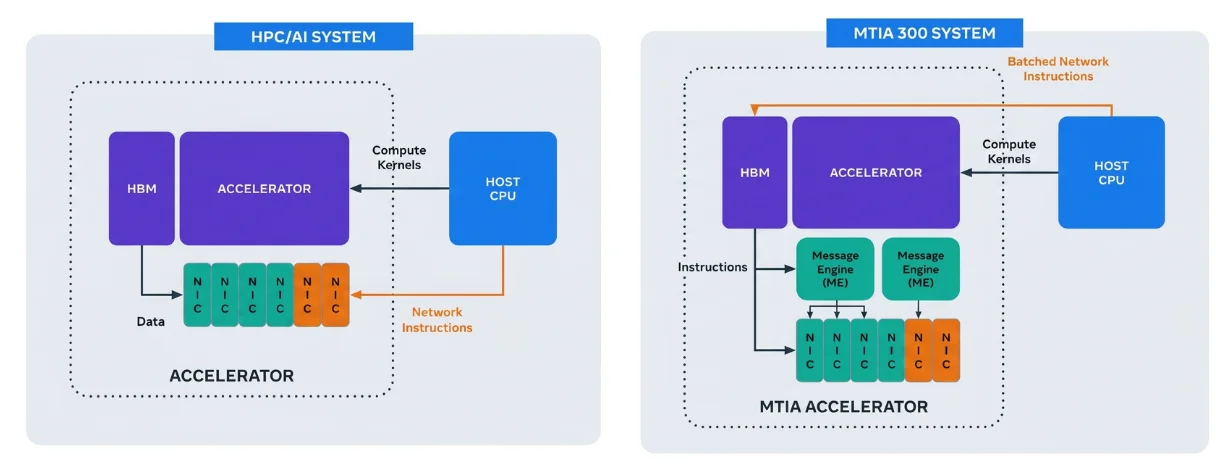
Meta 首先将网络接口移入加速器封装内部。MTIA 300 包含两个网络芯粒,每个芯粒配备六个定制的 800 Gbps RDMA NIC,提供总计 1.2 TB/s 的 I/O 带宽,且无需经过 PCIe 总线。这十二个 NIC 同时支持机架内的纵向扩展通信和机架间的横向扩展流量,让 Meta 能够在无需重新设计芯片的情况下调整带宽分配方式。
来源:Meta
将 NIC 移近计算端并未消除另一个资源争用问题:在传统 GPU 上,集合通信会占用训练任务本身所需的计算资源。而 MTIA 300 则配备了 16 个专用的消息引擎,独立于主计算网格处理通信,其中包括用于归约操作的近内存硬件。
Meta 表示,这种分离使得大型矩阵运算和集合通信能够并发运行,计算吞吐量仅下降不到 0.5%。而作为对比的 GPU 架构,在两类工作负载同时运行时,实测算力损耗超过 20%。
该硬件与 HCCL(Meta 的集合通信库)进行了协同设计。与在作业运行时由主机 CPU 编排每一次通信操作不同,HCCL 将集合操作编译为子图,MTIA 300 的消息引擎可以自主执行这些子图。一旦这些指令到达加速器,主机便不再参与驱动通信。
Meta 表示,在生产环境下,HCCL 在单个机架内可实现最高 940 GB/s 的通信带宽。针对一个部署在 40 个加速器上的 1500 亿参数推荐模型,MTIA 300 相比同等配置的 GPU 集群将总通信耗时降低至原来的 1/3.9(通信时间减少 3.9 倍)。
MTIA 300 也标志着 Meta 整体自研芯片项目的进一步扩张。Meta 表示,目前已经部署数十万 MTIA 加速器用于推理任务,并计划在未来两年推出四代后续产品,覆盖排序、推荐以及生成式 AI 各类工作负载。Meta 还扩大了与博通的合作,联合开发下一代 MTIA 芯片;同时仍会继续从 AMD、英伟达等厂商采购加速器,这就是 Meta 所谓的组合策略。
这一策略反映了超大规模云服务商正在普遍转向工作负载专用 AI 芯片。谷歌持续扩展其 TPU 计划,亚马逊不断壮大其 Trainium 业务,而微软正在开发 Maia 加速器的后续代际产品,因为云服务商正在寻找替代方案,不再完全依赖通用 GPU。
MTIA 300 体现出 Meta 在芯片专用化这条道路上走得有多彻底。Meta 没有把网络视作加速器外围的配套基础设施,而是围绕一种“数据迁移与数据计算同等重要”的业务负载,将计算单元、通信硬件以及集合通信软件做一体化协同设计。
查看英文原文:
🔥 热词:#meta自研芯片叫啥 · #Meta宣布自研AI芯片计划 · #meta自研ai芯片9月量产 · #meta芯片订单 · #Meta ai 芯片 · #MeTA是属于芯片半导体吗 · #mmt自研芯片 · #Meta技术解决方案