在2026年企业级AI与数据应用场景下,SQL查询性能优化迎来革新。以Snowflake Optima Planning为代表的技术,通过结合跨查询反馈与查询内部粒度匹配,大幅突破性能瓶颈。其核心机制在于双重适配:一方面,Optima Planning可针对单条查询的反馈机制,处理同一查询不同变体的重复执行场景;另一方面,基于计划片段与操作算子的匹配,补充无法覆盖的跨查询结构模式重复场景。工作流程上,查询编译后需对计划中的片段及操作算子计算基于优化器生成输出的哈希值,匹配后可直接复用执行反馈优化后续查询,兼顾整体查询与局部算子层面的性能提升,有效覆盖新增表、调整筛选条件或调整输出列等多种典型优化场景。
--91likeyou---
针对单条查询的反馈,回答的是一个重要问题:
这条查询,或者它的某种变体,之前是否执行过?
通过匹配计划片段或单个操作算子,则可以回答另一个互补的问题。它关注的并非整个查询,而是查询计划中的某个部分:
这个计划片段,或者某个特定的操作算子(例如连接操作),是否曾经出现在其他已执行的查询中?
两种机制结合起来,扩大了 Optima Planning 可以学习的查询范围,既涵盖相同查询,也涵盖结构模式重复但并不完全相同的查询。
工作原理
如今,Optima Planning 还可以在比完整查询更细的粒度上进行匹配,包括查询内部的计划片段(例如共享视图中的连接树),以及单个操作算子(例如某个特定的连接操作)。
从整体上看,其工作流程如下:
查询编译完成后,Optima Planning 会为查询计划中的每个计划片段和单个操作算子(例如某个特定的连接操作)计算哈希值。哈希值基于优化器针对该部分计划生成的输出,而非整个查询的 SQL 文本。
如果后续另一条查询包含具有相同哈希值的片段或操作算子,即使查询的其余部分完全不同,例如新增了一个此前从未参与连接的表,Optima Planning 仍能识别出其中的共同部分。
第一次查询执行产生的反馈信息会被用于第二次查询中对应片段或操作算子的计划优化。这样,即使第二条查询此前从未完整执行过,优化器也可以利用该部分已有的实际执行数据来选择查询计划,无需从零开始。
通过计划片段或单个操作算子进行匹配,可以找到不同查询计划之间的共同部分。但匹配成功只是意味着反馈信息具有复用的可能,并不代表一定会被采用。
Optima Planning 还会智能判断,将已有的执行反馈应用于新查询是否会造成过度泛化,即某些在原有上下文中成立的执行经验,在新的上下文中可能不再适用。如果判断反馈迁移的范围过大,就不会应用这些反馈信息。
关键在于,匹配依据是 Snowflake 优化器生成的查询计划中的片段或操作算子,而非整个查询的 SQL 文本。
这一机制并不会取代针对单条查询的反馈机制。后者已经能够处理同一查询的不同变体,而跨查询匹配旨在补充它尚未覆盖的场景:一条查询虽然不同于之前执行过的查询,却包含曾在其他查询中执行过的计划片段或操作算子。
两种机制之间的衔接十分清晰:查询内部匹配可以在全新查询首次执行时发挥作用。一旦同一查询第二次执行,它便拥有了自己的查询身份,与其他重复执行的查询一样,后续优化将由针对单条查询的反馈机制接管。
Snowflake 的优化器采用基于成本的优化方式:它会估算每个操作算子的输出行数,并选择预计执行成本最低的查询计划。当估算出现偏差时,优化器可能选择错误的连接顺序或构建侧,有时还会引发连锁反应,产生数十亿行不必要的中间结果。关于这一问题,我们在《提升重复查询性能》和《基于真实数据优化查询计划》中进行了更深入的介绍。
跨查询学习适用于哪些场景
为现有视图添加新的连接操作
-- v_customer_orders already joins customers, orders, and order_items, and already has feedbackSELECT * FROM v_customer_orders v JOIN returns r ON v.order_id = r.order_id WHERE ... -- new join, never run before复制代码
分析人员基于工作负载中已经广泛使用的视图构建查询,并新增一个此前从未以这种组合方式执行过的连接操作。虽然组合后的查询是全新的,具有新的查询身份,但 v_customer_orders 内部的连接片段早已存在,并非第一次执行。
在新报表中复用常见的连接模式
-- the customers-orders join already runs inside a dozen other reportsSELECT c.region, COUNT(*) FROM customers c JOIN orders o ON o.customer_id = c.customer_idWHERE o.status = 'RETURNED' GROUP BY c.region -- this exact report is new复制代码
这份报表是全新的,包含特定的 SELECT 列表和分组方式,此前从未执行过。但它依赖的客户表与订单表之间的连接操作并不新鲜:其他使用相同连接的报表已经积累了执行反馈信息。
逻辑相同,但 SQL 写法不同的查询
FROM orders o JOIN customers c ON c.customer_id = o.customer_id -- one BI tool's join orderFROM customers c JOIN orders o ON o.customer_id = c.customer_id -- a different tool, same result复制代码
两个 BI 工具可能生成相同的连接操作,但在 SQL 中以相反的顺序列出表。目前,这些 SQL 仍会被视为不同的查询。不过,由于计划片段或单个操作算子的匹配依据是查询计划中的操作算子,而非 SQL 文本中 FROM 子句的表排列顺序,因此两条查询仍然可以共享该连接操作的反馈信息。
在以上每种场景中,查询内部匹配都能够复用针对共同计划片段或操作算子已经积累的反馈信息。
一个模拟示例
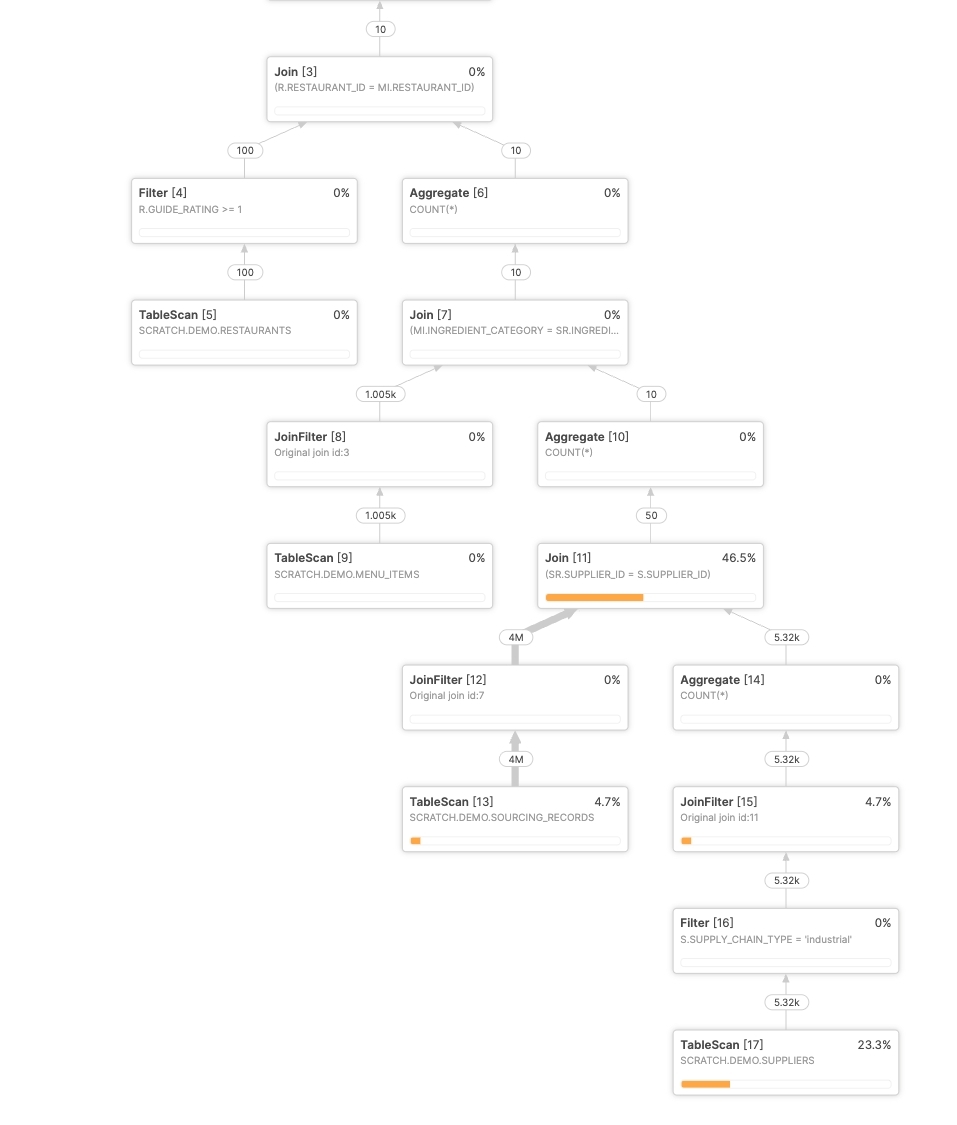
我们继续使用上一篇博客中的餐厅示例:restaurants、menu_items、sourcing_records 和 suppliers 四张表,通过 restaurant_id、ingredient_category 和 supplier_id 进行连接。
正如之前所介绍的,高评分餐厅通常只使用少数几种高端食材,而这些食材往往来自手工生产型供应商,而非工业化供应商。这种关联关系分布在三张表之间,因此,仅依靠单表统计信息无法识别。
下面是一条查询,我们将其称为查询 A:
SELECT COUNT(*)FROM restaurants rJOIN menu_items mi ON r.restaurant_id = mi.restaurant_idJOIN sourcing_records sr ON mi.ingredient_category = sr.ingredient_categoryJOIN suppliers s ON sr.supplier_id = s.supplier_idWHERE r.guide_rating >= 1 AND s.supply_chain_type = 'industrial';复制代码
首次执行时,优化器并不了解这些数据之间的关联关系,因此连接操作产生了大量中间结果,在过滤条件将结果集缩减至几乎为空之前,已经生成了数千万行数据。
再次执行时,Optima Planning 利用同一查询此前执行产生的数据,生成了更优的查询计划:
但如果遇到一条相似、却又不完全相同的查询,会发生什么?
下面来看查询 B。它使用与查询 A 相同的表连接关系和连接列,但输出列不同,评分筛选阈值也不同,并且增加了排序操作:
SELECT r.restaurant_id, mi.menu_item_id, s.supplier_nameFROM restaurants rJOIN menu_items mi ON r.restaurant_id = mi.restaurant_idJOIN sourcing_records sr ON mi.ingredient_category = sr.ingredient_categoryJOIN suppliers s ON sr.supplier_id = s.supplier_idWHERE r.guide_rating = 1 AND s.supply_chain_type = 'industrial'ORDER BY r.restaurant_id, mi.menu_item_id;复制代码
由于优化器此前从未见过这条完全相同的查询,因此它在生成高质量查询计划时遇到了困难,就像第一次执行查询 A 时一样。
最终,连接操作产生了大量中间结果,整个查询的执行时间约为 13 秒。
借助这项新功能,我们可以将查询 A 中的基数估算信息应用于查询 B。
这意味着,即使查询 B 是第一次执行的全新查询,优化器也能够直接生成经过改进的查询计划。
采用新计划后,查询执行时间缩短至约半秒:
对于一条此前从未执行、也没有自身历史执行记录可供参考的查询而言,这相当于实现了约 26 倍的性能提升。
一个真实生产案例
下面这个来自美国一家大型医疗健康科技公司的真实查询案例,展示了该功能的实际效果。
一家客户执行了一条包含 19 个连接操作和多个相互关联的连接谓词的分析查询。这类复杂查询结构往往会让传统的基数估算方法面临挑战。
由于优化器生成了次优的查询计划,连接操作产生了数十亿行中间结果,最终导致查询耗时接近两小时。
在后续的一次查询执行中,优化器成功利用了另一条结构相似、但并不相同的查询所提供的跨查询反馈,改善了基数估算结果,并生成了更优的执行计划。
最终,查询执行时间仅为 30 秒!
这个案例体现了跨查询反馈真正的突破所在:一条查询即使没有自己的历史执行记录,也能够从其他查询的执行经验中获益。
只要它使用的连接结构曾在工作负载中的其他查询里出现过,Optima Planning 就可以立即利用这些经验,即使是在这条查询首次执行时也不例外。
哪些情况下能够发挥作用
当一条真正全新的查询,与此前执行过的查询共享某个计划片段或单个操作算子时,这项能力的价值最大。
通过在查询内部进行匹配,Optima Planning 能够将反馈机制扩展至不同的查询。
尤其适用于以下情况:
查询的执行成本较高,一旦选择了不合理的执行计划,就可能触发大规模扫描或连接操作;
查询本身是全新的,例如引入了新的连接、新的表或新的组合,但它基于已有视图、CTE(公用表表达式)或工作负载中其他查询曾经使用过的常见连接模式进行扩展;
分析人员编写的临时查询复用了其他多份报表中经常出现的连接模式,即使这份具体报表此前从未运行过;
SQL 由 BI 工具或大语言模型(LLM)全新生成,例如 Cortex Analyst、Tableau Pulse;
两个 BI 工具或 ORM(对象关系映射工具)以不同的连接顺序编写了相同的连接操作。目前,这些 SQL 仍被视为不同的查询。
在上述场景中,相较于匹配整个查询,通过匹配计划片段或单个操作算子,可以显著扩大查询计划优化的覆盖范围。
客户如何查看 Optima 的优化效果
客户可以通过查询历史记录(Query History)中的查询性能分析(Query Profile),包括查询洞察(Query insights)面板和统计信息(Statistics)面板,以及 QUERY_INSIGHTS 视图,监控 Snowflake Optima 的使用情况。有关完整机制的介绍,请参阅《基于真实数据优化查询计划》。
具体到 Optima Planning,客户可以查看 Snowflake 何时应用了优化洞察,以提升查询计划的质量。目前,这种新的匹配方式与 Optima Planning 其他反馈机制使用相同的客户可见提示信息:“This query benefits from Snowflake optima planning.”(此查询受益于 Snowflake Optima Planning 的优化。)现阶段,系统尚未提供单独的提示信息,用于区分通过计划片段或操作算子匹配获得的反馈,以及通过同一查询匹配获得的反馈。两种情况在 Query Profile 和 QUERY_INSIGHTS 中的呈现方式完全相同。
核心要点
Optima Planning 的核心在于:利用更可靠的执行数据,生成更优的查询计划。
如今,针对单条查询的反馈与跨查询反馈相结合,已经能够覆盖工作负载生命周期中的更多场景:
重复执行的工作负载: 对于仪表板、定时报表和 ELT 数据流水线,Optima Planning 可以从历史执行中学习连接操作产生大量中间结果的情况,持续改善查询性能;
基于已有查询结构扩展的新查询: 当新查询在现有视图、CTE 或其他查询已使用过的常见连接模式上增加新的连接操作时,即使是首次执行,也能够利用已有计划片段的反馈信息;
生产环境中的实际效果: 在真实生产工作负载中,跨查询反馈将一条包含 19 个连接操作的分析查询的执行时间,从近两小时缩短至 30 秒。
无需手动调优,无需手动配置,即可获得更优的查询计划。
原文地址:
点击链接立即报名注册: Snowflake 精彩活动请关注专区
🔥 热词:#sql查询性能优化有哪些 · #sql查询从入门到实践 · #SQL性能优化 · #sql从入门到项目实践 · #sql入门到实践 · #数据库原理与实践教程sql · #sql入门与实践指南 · #sql提高查询效率的方法