2026年,智能体在企业级应用中将迎来实质性突破,Event智能等新工作方式正加速落地。Snowflake针对动态表场景推出显著优化,核心是通过复用已有计算结果,实现动态表增量刷新。聚合流水线是常见模式,以动态表按客户、账户或设备分组汇总数据,依托GROUP BY自动保持最新。在优化层面,针对动态表顶层GROUP BY且数据局部变化的场景,Snowflake可直接复用存储结果计算,无需从头重算,显著降低计算开销。测量数据显示,优化后平均刷新耗时降低约40%,超三分之二任务耗时缩短超10%,单次最高提升达147倍。该优化仅适用于顶层GROUP BY且无更上层操作的场景,需将多层操作拆分至多张动态表以满足条件。优化从性能与成本双重维度提升,为动态表高效调度提供了关键支撑,推动企业数据处理效率显著提升。
--91likeyou---
增量刷新中容易被忽视的问题
假设有一张动态表,用于持续汇总每个电表的累计用电量及峰值读数:
CREATE OR ALTER DYNAMIC TABLE dt_meter_consumption TARGET_LAG = '5 minutes' WAREHOUSE = pipeline_whAS SELECT meter_id, SUM(kwh) AS kwh_total, MAX(kwh) AS kwh_peak FROM meter_readings GROUP BY meter_id;复制代码
理论上,这条查询应该能够进行增量更新,并具有良好的成本效益。毕竟,meter_readings 中只有一小部分数据发生变化,所需的计算工作量理应也很小。
这个判断有一半是正确的。假设新增了 100 条读数,涉及 40 个电表,那么只有 40 个数据分组受到影响,其余数百万个分组都没有变化,可以完全不予处理。将计算范围缩小至受影响的分组,是最容易实现的优化。动态表一直具备这一能力。
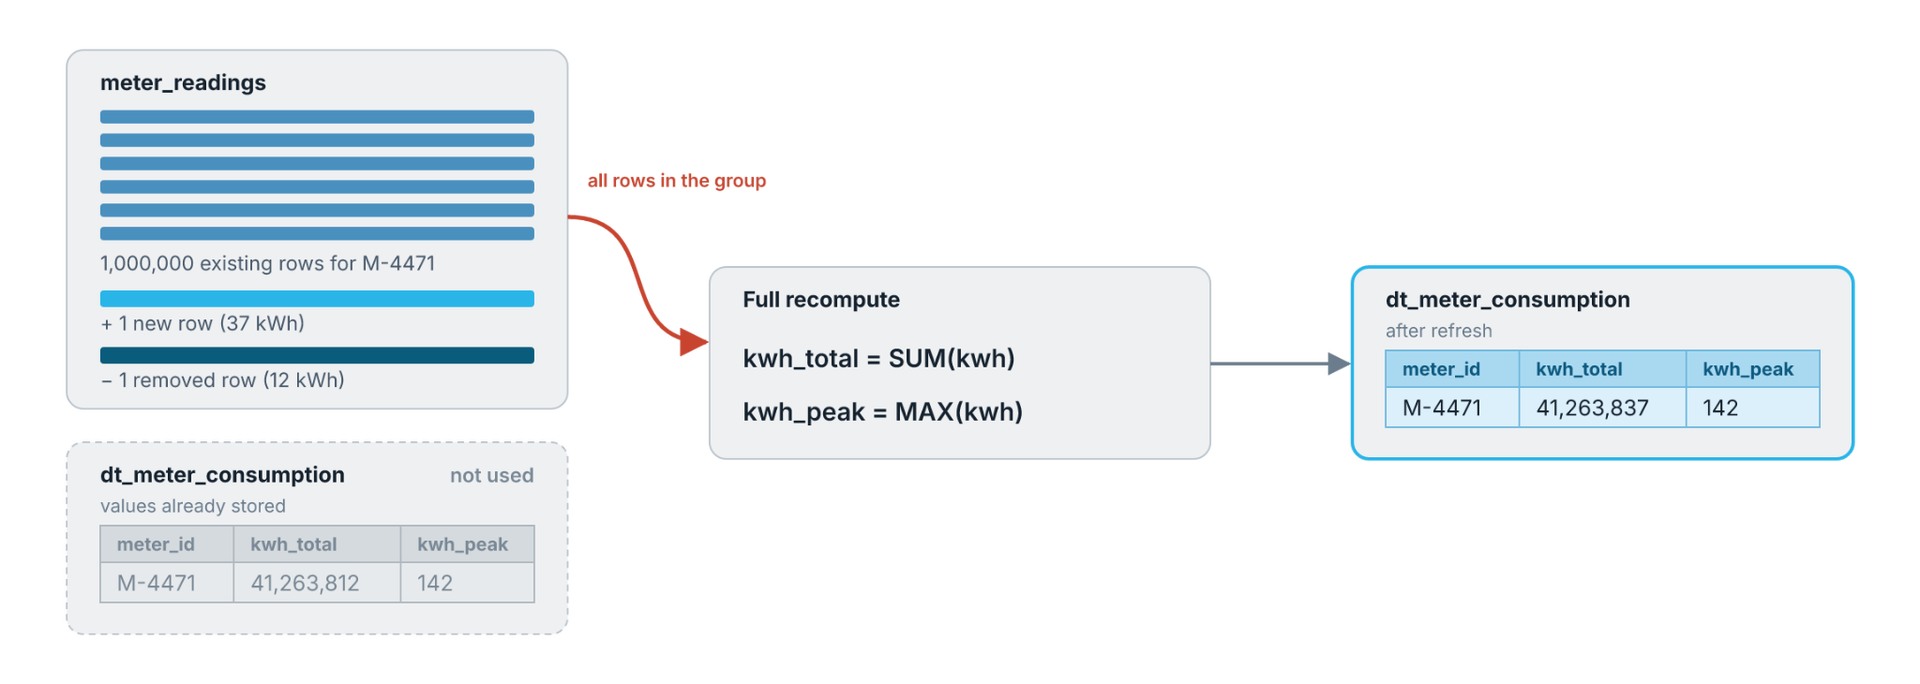
真正复杂的是另一半:知道哪些分组发生了变化,并不意味着能够直接得出它们更新后的值。聚合值需要根据分组内的所有行计算得出,因此,获取新聚合值最直接的方法,就是重新读取该分组的所有数据行并再次计算。这意味着,即使某个电表只新增了一条读数,只要它已有 100 万条历史读数,就需要重新读取这 100 万条数据参与计算。变化的只有一行数据,计算成本却相当于处理整个分组。
这正是动态表此前存在的不对称性:计算工作量取决于受影响分组的大小,而非引发变化的数据量。
利用已有结果进行增量计算
这一优化的关键在于,动态表已经保存了上一次刷新时的计算结果。如果某个电表此前的累计用电量已知,此后又新增了一条读数,那么计算新的累计值就不需要重新遍历多年的历史数据。
Snowflake 现在采用的正是这一方式。对于符合条件的动态表定义,刷新过程会复用动态表中已经存储的值,仅根据实际发生变化的数据行更新聚合结果。这样一来,计算工作量就与变化的数据量成正比,而不再取决于受影响分组的大小。
具体实现方式取决于聚合函数。SUM 是最简单的情况,因为新值可以直接根据旧值进行算术运算:
newSum = oldSum + insertedSum - deletedSum复制代码
换句话说,新值等于原有存储值,加上新增数据的汇总值,再减去删除数据的汇总值,完全不需要读取任何源数据行。计数也采用相同的方式,Snowflake 基于求和与计数推导出的其他聚合结果同样能够受益,包括平均值、标准差和方差等。
对于 MAX,只要数据变化仅涉及新增行,也可以采用类似的方法:新读数要么超过此前存储的峰值,要么没有超过。因此,新值就是 max(oldPeak, insertedPeak)。
删除操作则更加复杂,因为并非所有聚合函数都具有可逆性。对于 SUM,只需执行公式中的减法即可:如果从 meter_readings 中删除一条重复的 12 kWh 读数,累计值就会相应减少 12 kWh。但对于 MAX,如果当前最大值被删除,情况就不同了。原先存储的最大值已经失效,而新的最大值可能是该分组中其余 100 万条数据中的任意一个,因此,仅依靠原有值无法完成更新。Snowflake 能够识别此类情况并重新计算聚合值,但只会对确实需要重新计算的分组执行这一操作,其他所有分组仍然可以享受新优化带来的收益。
性能提升的幅度取决于聚合函数以及数据变化的具体情况,但整体效果十分显著。Snowflake 的内部测量涵盖了符合此次优化条件、且具有顶层 GROUP BY 操作的动态表,测量范围仅限于此前刷新耗时超过 3 秒的情况。结果显示,总刷新耗时平均降低约 40%,超过三分之二的刷新任务耗时至少缩短了 10%。 其中,观察到的最大单次性能提升达到 147 倍:某次刷新原本需要约 377 秒,优化后仅用约 2.5 秒便完成。
当聚合操作之上还有连接操作时
这一优化对结构有明确要求:GROUP BY 必须是动态表的顶层操作。如果聚合操作之上还有其他操作,例如连接(JOIN)或联合(UNION),就无法启用该优化。HAVING 子句则受到支持,因为它属于分组操作的一部分。
假设有一张表用于跟踪每个电表的用电读数,并通过关联每个电表所属站点的信息来丰富数据:
CREATE OR ALTER DYNAMIC TABLE dt_site_consumption TARGET_LAG = '5 minutes' WAREHOUSE = pipeline_whAS SELECT s.site_name, s.tariff_band, m.kwh_total, m.kwh_peak FROM ( SELECT meter_id, SUM(kwh) AS kwh_total, MAX(kwh) AS kwh_peak FROM meter_readings GROUP BY meter_id ) m JOIN dim_sites s ON m.meter_id = s.meter_id;复制代码
在这个定义中,聚合操作位于子查询内部,其上层还有连接操作,因此 GROUP BY 并不是顶层操作,该定义不符合优化条件。
解决方法是将这两项任务拆分到两张动态表中。第一张表只负责聚合,第二张表则在聚合结果的基础上执行连接操作:
CREATE OR ALTER DYNAMIC TABLE dt_meter_consumption TARGET_LAG = DOWNSTREAM WAREHOUSE = pipeline_whAS SELECT meter_id, SUM(kwh) AS kwh_total, MAX(kwh) AS kwh_peak FROM meter_readings GROUP BY meter_id;CREATE OR ALTER DYNAMIC TABLE dt_site_consumption TARGET_LAG = '5 minutes' WAREHOUSE = pipeline_whAS SELECT s.site_name, s.tariff_band, m.kwh_total, m.kwh_peak FROM dt_meter_consumption m JOIN dim_sites s ON m.meter_id = s.meter_id;复制代码
现在,聚合操作有了一张独立的动态表,GROUP BY 位于顶层,并且分组键和两个聚合值都直接出现在查询的选择列表中,因此符合优化条件。TARGET_LAG = DOWNSTREAM 使这张表能够根据下游使用方的需求,按照相应的调度计划进行刷新;连接操作则被移至另一张专门负责连接的动态表中。
此外,这种拆分还有一个额外好处:聚合结果现在可以供其他需要使用它的对象复用。
如何享受这一优化带来的收益
对于具有顶层聚合操作的动态表,此次优化进一步提升了其性能与成本效益。请参阅 动态表刷新优化文档,确认您使用的动态表是否能够从这一优化中受益。
原文地址:
点击链接立即报名注册: Snowflake 精彩活动请关注专区
🔥 热词:#Snowflake · #复用已有计算结果 · #动态表增量刷新如何实现性能与成本双优化 · #技术实践 · #2026 · #智能体将在企业级应用中取得哪些实质性突破 · #点击下载《2026 · #AI