简介
在湖仓分析系统中,存储布局并无普适最优方案。基于Delta Lake的基准测试表明,Liquid Clustering在点查询、时间范围聚合及大型聚合场景中均能实现最低延迟。针对多样化查询模式的团队,Liquid Clustering宜设为默认配置。ZOrdering仅在稳定高选择性多谓词负载中表现更佳,且要求过滤列与聚类键完全匹配。分区、ZOrdering与Liquid Clustering在数据组织上采取不同策略,其权衡取舍直接影响系统性能。本文通过受控测试揭示了不同工作负载下布局的优劣,既包含与常规认知相悖的反直觉结果,也揭示了生产场景中潜在的性能隐患。综合结论指出,布局决策前需验证查询模式是否稳定且可由固定两三个列筛选,若满足条件应选用ZOrdering;若查询模式多变或不确定,Liquid Clustering作为默认方案更为合适,且已在三种负载中实现性能优势,同时降低运维成本。
--91likeyou---
多列过滤器中 Liquid Clustering 的精度差距
当查询谓词能与一组稳定的过滤列精确匹配时,ZOrder 的文件剪枝效果接近最优,而 Liquid Clustering 在扫描多出十倍的数据时,运行速度可能变成五分之一。Liquid Clustering 采用更广泛的局部优化策略,以牺牲确定性剪枝为代价换取工作负载的灵活性。当查询范围狭窄而且可预测时,这种权衡恰恰会成为一种负担。
这些测试结果之所以重要,是因为物理数据布局是湖仓工程中影响最为深远却鲜少被讨论的决策之一,而分区、ZOrdering 和 Liquid Clustering 之间的权衡通常仅从概念上进行了描述,并没有通过实际测量来验证。
大多数已经发表的对比研究要么来自 Databricks 自己,要么是基于第一性原理推导出的权衡分析,并未针对实际的查询行为进行度量。本次基准测试所探讨的问题,直接源于我在 TCS 英国分公司(民用航空航天领域)和 IBM(壳牌海事)设计 Delta Lake 平台时实际遇到的生产挑战。在这些场景中,数据布局决策会直接影响管道服务水平协议(SLA)的合规性以及云计算的成本。
我的实际建议是:在确定布局策略之前,请针对你自身数据的一个具有代表性的样本,将最常用的三种查询模式分别应用于分区、ZOrdered 和 Liquid Clustered 这三种配置。下面的结果来自一项受控基准测试。该测试使用真实的 Databricks 查询配置文件,在包含 5000 万条记录的数据集上,针对四种分析型工作负载类型对这三种布局策略进行了比较。这些结果可能会让你感到惊讶,就像当初让我感到惊讶一样。
这在实践中意味着什么
综合来看,这些测试结果基于工作负载类型勾勒出了一个清晰的决策框架:
本文中最具实践价值的见解,或许是一个看似简单却极具洞察力的诊断性问题——在确定任何布局策略之前,实践者都应该自问:我的热门查询是否总是根据相同的两到三个列进行筛选?仅凭对这一问题的回答,就能判断复合分区究竟能带来实质性的收益,还是会引入不必要的复杂性。
如果答案是“是”,即这些列是已知的而且很稳定,那么就应该仅对这些列使用 ZOrder,从而确保选择性最高的列排在首位。如果答案是否定的,或者查询模式可能发生变化,那么就应该将 Liquid Clustering 设为默认选项。在四种工作负载类型中,Liquid Clustering 在其中三种中表现更优,并且消除了手动调度 OPTIMIZE 带来的运维开销。GitHub 上提供了一个用 Python 编写的决策辅助工具。
下文将详细阐述这些建议背后的方法论、结果和分析,即如何和为何,供希望在应用这些发现之前进行验证的读者参考。
实验设置
以下是数据集、布局配置、工作负载以及分析结果。
数据集
我们生成了一组包含五千万条记录的合成事务数据集,用于模拟零售购买环境,其数据模式如下:
customer_id INT uniform distribution, range 12,000,000txn_date DATE spanning 20192023region STRING categorical: EU, US, APAC, LATAM (skewed toward EU/US)amount FLOAT rightskewed, simulating highvalue outliersproduct_cat STRING categorical, 12 categories复制代码
这种均匀分布与偏态分布的混合是刻意设计的,其参数是根据生产日志中实测的访问频率模式进行校准的。具体而言,选择诸如客户细分市场的 Zipf α = 1.2 以及 80/20 热分区划分等偏度参数,为的是匹配实际工作负载中观察到的查询量分布。这些数值不是随意选的,而是源自生产环境的遥测数据——其中排名前 20% 的客户细分市场始终占查询流量的约 80%,这样可以确保合成数据集能够反映现实世界中的热分区和需求偏度。
布局配置
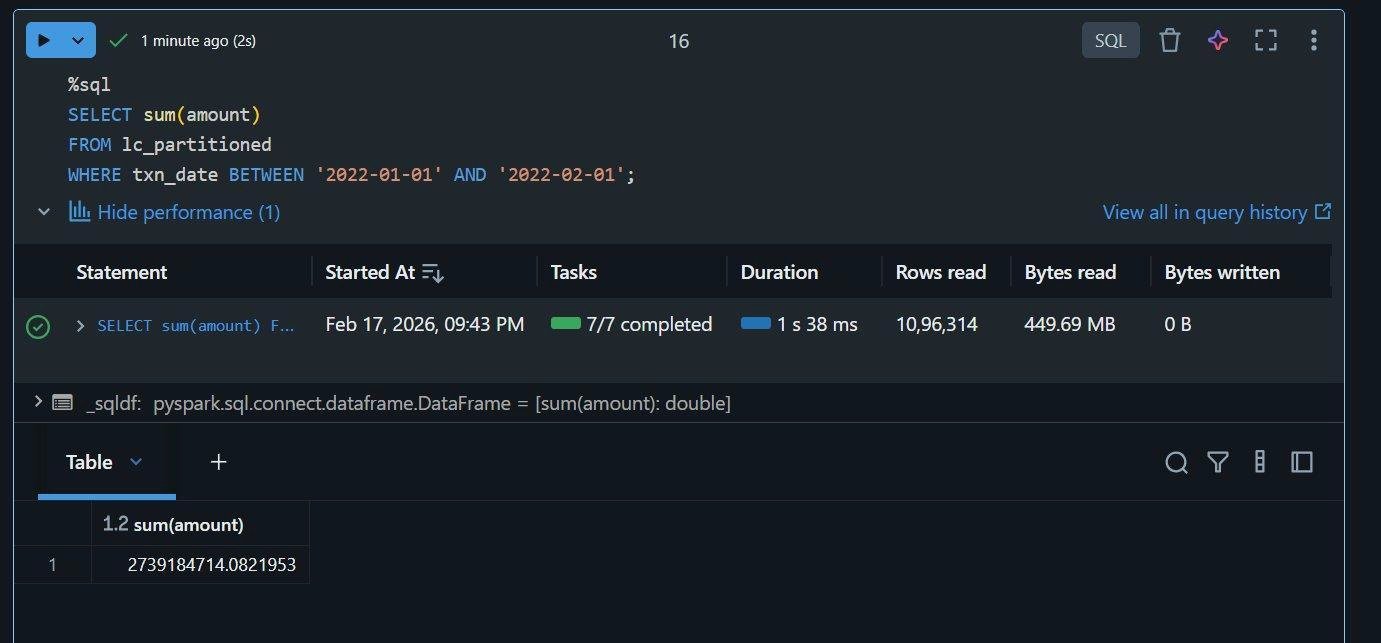
Partitioned tabledf.write.format('delta').partitionBy('txn_date').saveAsTable('lc_partitioned') ZOrdered tablespark.sql('OPTIMIZE lc_zorder ZORDER BY (customer_id, region, txn_date)') Liquid Clustered tablespark.sql(''' CREATE TABLE lc_liquid CLUSTER BY (customer_id, region, txn_date) AS SELECT * FROM source_data''')复制代码
工作负载
GitHub 上提供了所有的查询。
结果
W1:点查询
Liquid Clustering 实现了 1.003 秒的最低延迟,比分区基线快了 49%,尽管它扫描的原始数据量比 ZOrder 更多。这是第一个反直觉的结果,即读取的字节更多反而带来了更好的性能。其原因在于文件内部的顺序局部性。Liquid Clustering 采用的希尔伯特曲线组织方式,能更有效地将相关 customer_id 值集中在同一个文件中,可以减少磁盘寻道开销、提高扫描吞吐量。ZOrder 虽然通过文件剪枝减少了读取的字节数,但访问更多文件所产生的开销抵消了这一优势。
W2:时间范围聚合
Liquid Clustering 再次以 659 毫秒的延迟创下了最低纪录。ZOrder 的表现比分区基线差:ZOrder 耗时 1.845 秒,而分区方法仅需 1.038 秒,速度慢了 78%。ZOrder 的聚类键为 (customer_id, region, txn_date),这使得 txn_date 成为三级键。这种设计会将顺序日期值分散到不同的文件中,破坏了简单分区所天然具备的日期范围扫描效率。如果你的团队对多个列进行 ZOrder 排序,而且日期并非第一个键,那么这几乎肯定会影响你的时间范围查询性能。
W3:多列选择性过滤
该工作负载展现出了最显著的性能反差。ZOrder 仅耗时 615 毫秒,读取数据量仅为 59.03 MB。而 Liquid Clustering 则耗时 2.967 秒,读取数据量达 639.95 MB,速度慢了近五倍,而且扫描的数据量多出十倍。当查询谓词与 ZOrder 的聚簇键组合精确匹配时,ZOrder 的文件剪枝效果接近最优。Liquid Clustering 更广泛的局部性优化(旨在应对工作负载多样性)在此反而成为劣势,因为它无法像 ZOrder 那样实现同等精度的文件消除。ZOrder 通过固定的列顺序来精确剪枝,而 Liquid Clustering 则以灵活性为代价牺牲了这种精度,这种权衡使其在该工作负载下付出了代价。如果你的工作负载主要是针对已知列的、稳定的、高选择性的多列过滤,那么 ZOrder 仍然是正确的选择。
W4:大规模聚合
对于按区域分组的完整数据集的 SUM 聚合操作(使用与 W2 相同的查询,但未对整个数据集进行谓词过滤,以便更清晰地展示基准测试数据),Liquid Clustering 再次实现了最低延迟(659 毫秒),而 ZOrder 的延迟最长(1.845 秒)。对于全表扫描工作负载,文件剪枝并无益处;性能的关键因素转向了文件内部的读取效率和任务调度,这两方面都更有利于 Liquid Clustering 的希尔伯特曲线局部性。
讨论
同样的两种机制解释了所有四个工作负载中的结果:文件剪枝效率(即该布局所避免读取的数据量)和文件内局部性(即读取数据的扫描效率)。ZOrder 和分区算法主要在剪枝方面展开竞争。Liquid Clustering 则主要凭借其希尔伯特曲线组织方式在局部性方面胜出,即使其读取的字节数多于 ZOrder 也是如此。当查询与稳定的聚类键精确匹配时,剪枝效果占主导地位,ZOrder 胜出(W3)。当查询不匹配,或无法避免全表扫描时,局部性占主导地位,Liquid Clustering 胜出(W1、W2、W4)。ZOrder 的日期范围故障模式(W2)是从另一角度观察到的“剪枝与局部性”之间的权衡。将日期设为三级键,会牺牲日期分区所天然提供的顺序局部性,却未能获得足够的剪枝效益来弥补这一损失。
注意
这些基准测试使用的是合成数据集,可以确保结果可重复,并且能避免泄露客户数据。实际的生产数据集还存在额外的复杂性,如模式漂移、访问模式的季节性变化以及特定领域的偏斜,这些因素可能会改变每种布局的相对性能。本文呈现的研究结果仅应作为一种方向性参考,在做出不可逆的模式决策之前,一定要根据你自身的工作负载特征进行验证。
此外,我并未测量 I/O 的写入放大开销,也未测量在新增数据到达时维护每种布局所需的计算开销。Liquid Clustering 的增量方法比 ZOrder 的周期性全表重写具有更低的写入时间成本,但这并未通过实验进行测量,需要另行研究。
小结
对于湖仓分析系统而言,并不存在一种放之四海皆准的最佳存储布局。Liquid Clustering 在点查询、范围扫描和大型聚合操作的延迟方面表现更佳,应成为工作负载多样或不断演变的团队的默认选择。ZOrdering 则更适用于稳定且高选择性的多谓词工作负载,即过滤列与聚类键精确匹配的情况。
两项最具实际意义的发现——当将日期作为二级键时,ZOrdering 在范围扫描中的性能下降,以及 Liquid Clustering 在多列精确过滤场景下延迟增加五倍——是尚未被记录的故障模式,而且很可能正在影响当前的生产系统。
请在具有代表性的数据样本上,针对这三种布局配置运行你最常用的三种查询模式。结果可能会让你大吃一惊。
:
🔥 热词:#Liquid · #Clustering · #ZOrder · #何时应使用 · #湖仓布局策略基准测试 · #简介对于湖仓分析系统而言 · #并不存在一种放之四海皆准的最佳存储布局。在 · #Delta