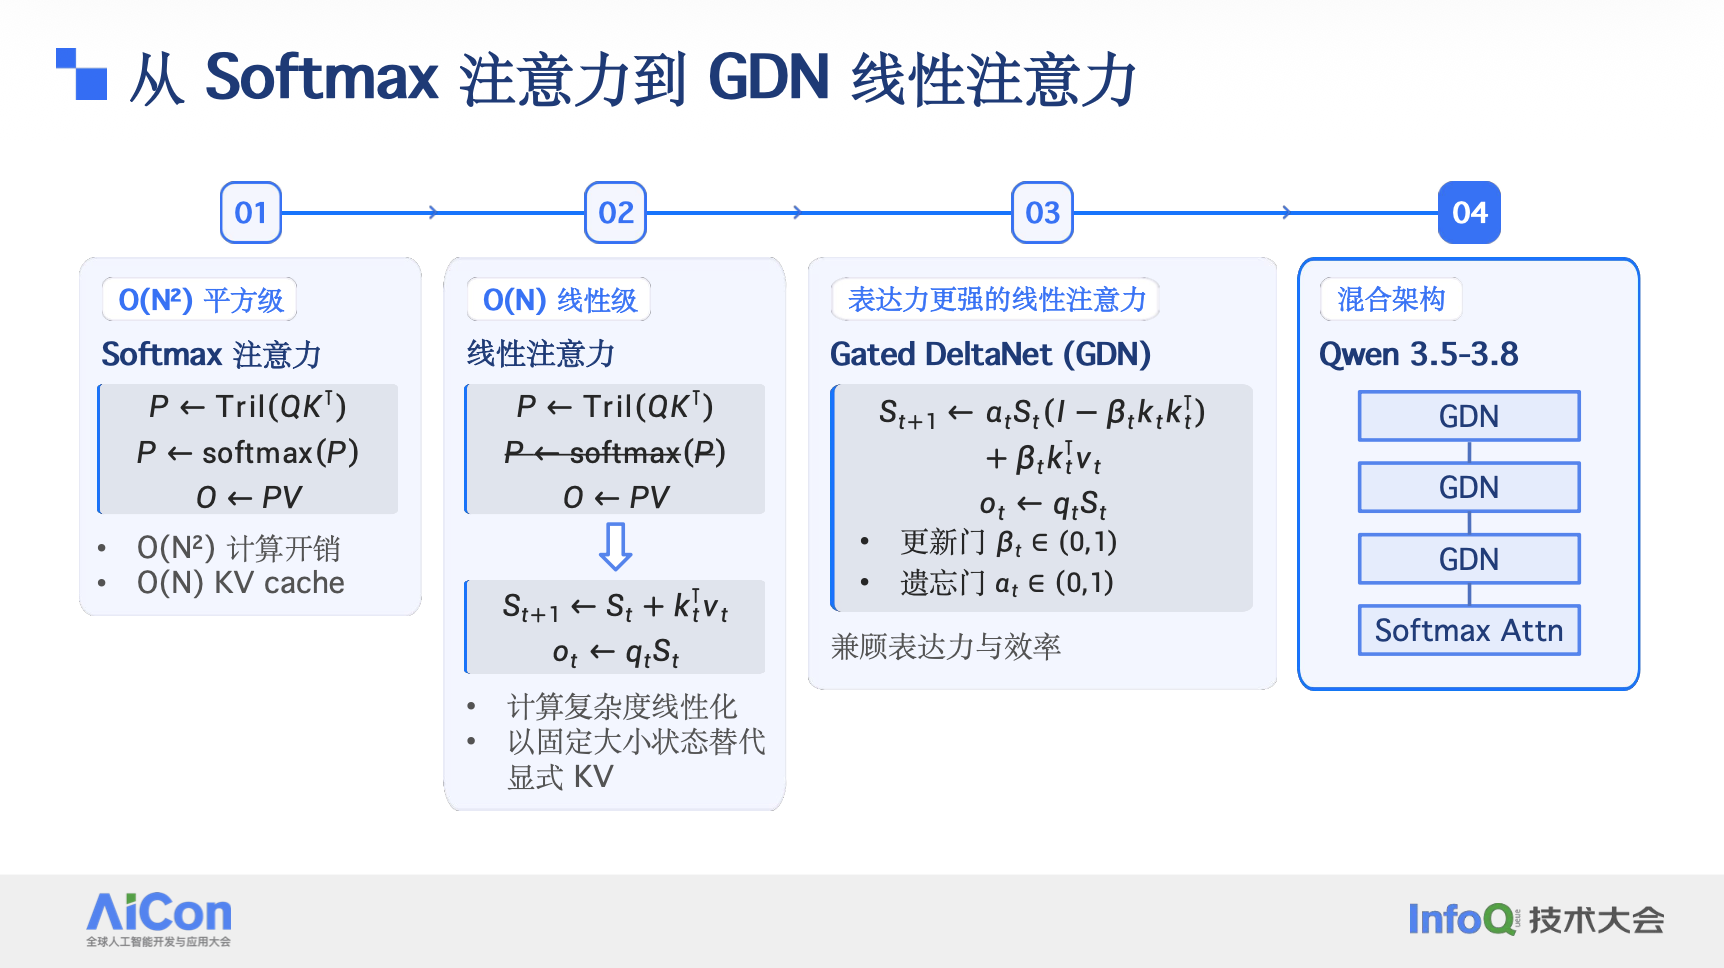
在大型模型序列长度不断攀升至百万级的背景下,softmax注意力算力的内存与计算开销日益凸显制约。当前以Qwen、Kimi为代表的模型正转向线性注意力与softmax混合架构,然而线性注意力的高效GPU实现仍面临并行度受限、访存冗余及SFU负载过重等关键挑战。本文基于阿里巴巴Qwen团队算法工程师章程瑞东在AICon 2026深圳站的分享,系统阐释了FlashQLA的优化逻辑与落地实践。FlashQLA定位为面向Gated Delta Network线性注意力的高性能GPU算子库,通过解决向量点积、外积计算效率低、GPU利用率不足等痛点,实现了线性注意力的高效计算。其优化核心包含四大关键技术:其一为滑动窗口性质利用,通过递推公式将token级计算转化为chunk级并行运算,有效突破GPU硬件瓶颈;其二为硬件友好代数改写,将复杂运算转化为更适配硬件的计算形式,提升算力利用率;其三为Warp specialization实现,基于底层算子优化适配GPU架构,提升计算效率。此外,FlashQLA还结合线性注意力混合架构,通过合理引入Gated Delta Network与原始softmax注意力组合,兼顾表达力与召回能力,实现性能提升。其通过序列并行、协同算子优化等手段解决并行度不足与状态传递开销问题,并完成性能基准测试,验证了在Qwen等模型中的良好适配效果,为大规模模型线性注意力优化提供了可参考的技术路径。
--91likeyou---
🔥 热词:#面向芯片化的具身智能模型优化与适配属于什么专业 · #qwen模型的性能如何 · #qwen模型与gpt对比 · #qwen向量模型 · #qwen模型再训练 · #线性模型引论第一版是04版吗 · #线性模型分析原理2000年 · #面向文本环境的世界模型