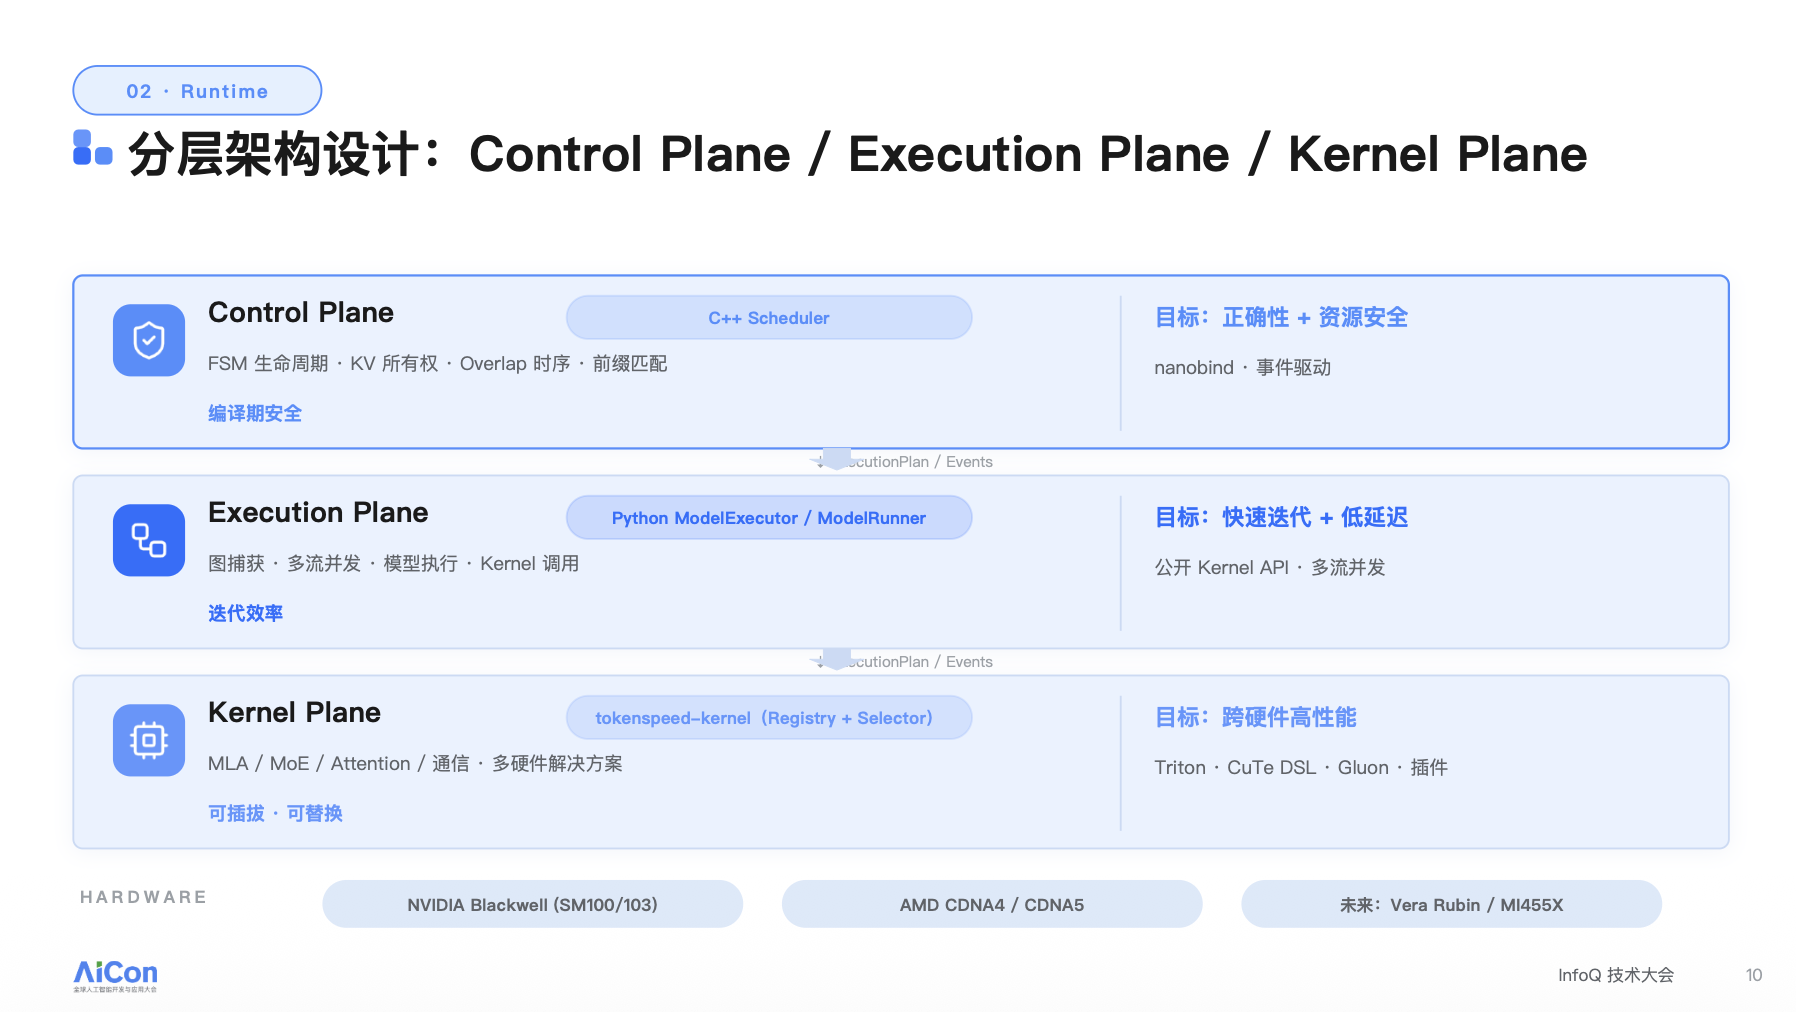
在Agent推理负载快速增长的背景下,传统推理引擎面临吞吐优化失效、缓存利用率不足等结构性挑战。本文依据TokenSpeed贡献者分享,围绕Agentic推理场景展开分析,梳理了从立项到迭代的技术路径。文章指出,Agent场景以多轮短请求循环为特征,对延迟与缓存复用要求显著高于传统聊天场景,提出以每用户TPS不低于70为性能指标,在Blackwell等硬件上实现端到端延迟提升9%与每GPU吞吐提升11%的目标。同时,针对KV Cache复用率从70%-80%向99%以上的演进趋势,分析线性注意力等新型架构对缓存管理的新要求,并结合MOE等模型架构特性与Blackwell、CDNA等硬件特性,提出基于Kernel的深度优化与Runtime与调度器的协同解耦设计,构建多层次架构以实现自动化并行编译,保障系统高效运行。
--91likeyou---
🔥 热词:#llm大模型推理能力更强 · #大模型推理引擎 gpu支持 · #推理引擎关键技术 · #大模型推理引擎有哪些 · #deepseek推理引擎 · #AI推理引擎硬件 · #ai2推理大模型显著的特点是 · #DeepSeek的推理模型更适合处理以下哪种