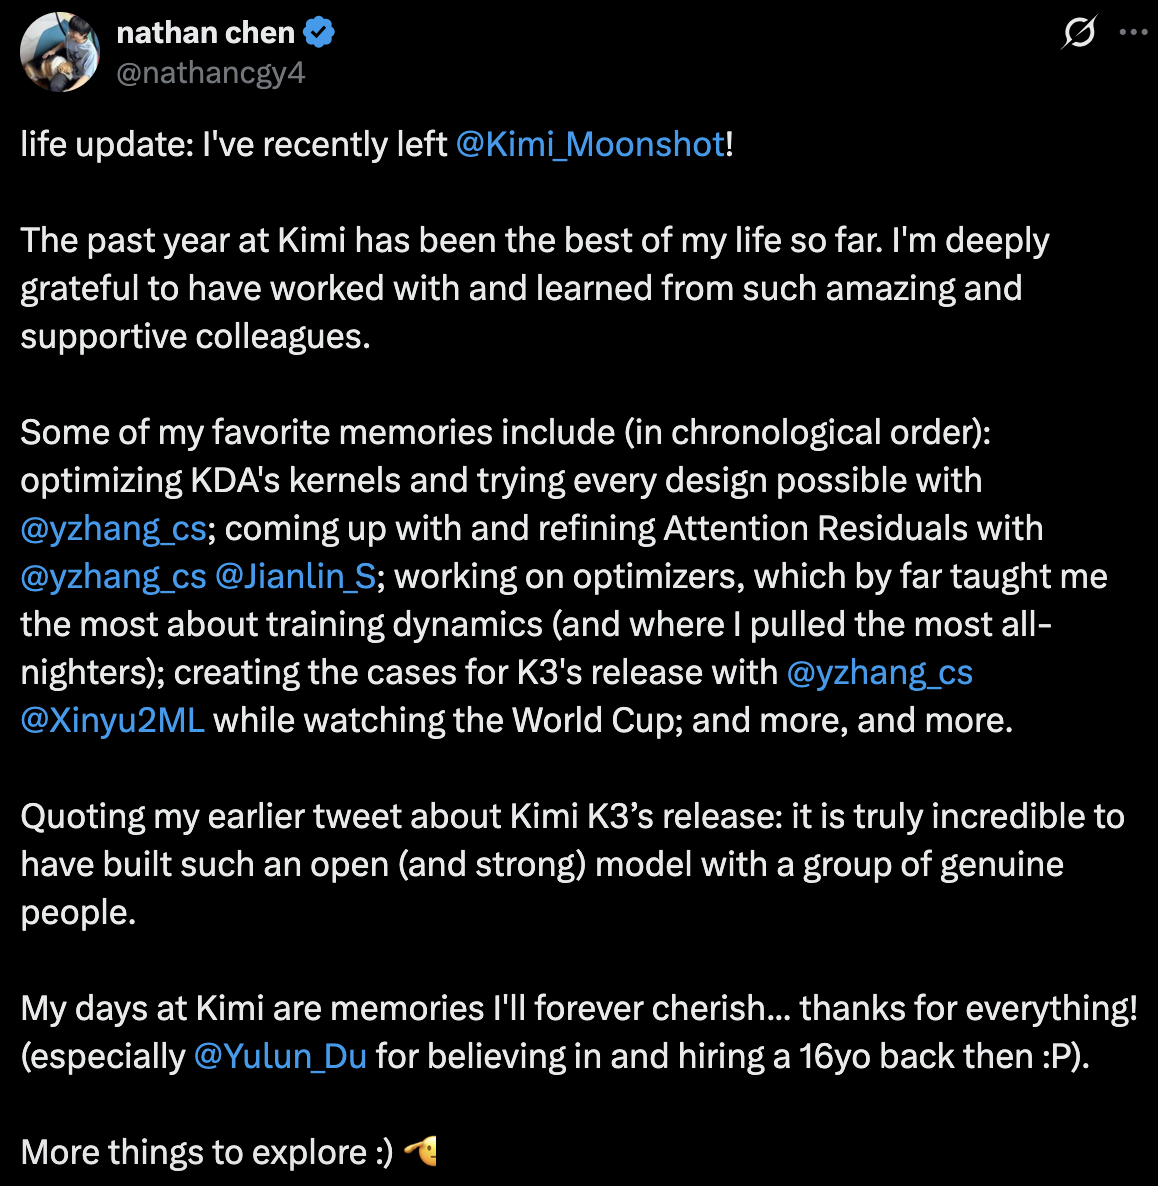
17岁Kimi架构核心参与者陈广宇宣布离职并计划赴美国旧金山湾区,这一变动引发广泛猜测,聚焦其后续加入哪家AI企业、承担何种角色。陈广宇作为共同第一作者参与Kimi底层架构研究,近期在社交平台明确表示将离开现有平台,并高度肯定过去一年在Kimi参与的经历,称其为人生中最美好的时光,感谢团队给予16岁时的培养机会。其所在平台Anthropic联合研究员向陈广宇发出邀请,期望其前往旧金山加入现有团队,相关互动进一步引发表局争议。当前确定其已离开Kimi、将赴湾区,但具体下一家雇主、职位及入职时间仍存未知。陈广宇的研究贡献以核心技术突破为主,包括在Attention Residuals、MoMoE、优化器与GPU算子及训练效率方向展开研究成果,涵盖模型架构设计、计算内核优化及大规模训练适配。其在Kimi期间的工作聚焦大语言模型扩展与预训练,涉及Kimi K3等项目,研究方向覆盖模型架构、优化器及高效计算内核等关联领域。尽管外界对其是否加入Anthropic、后续就业路径存在猜测,但其积累的技术成果、专业研究能力与突破方向,仍为行业观察提供重要参考。
--91likeyou---
陈广宇此前的个人主页显示,他在 Kimi 从事大语言模型扩展与预训练工作,涉及 Kimi K3,研究重点包括模型架构和优化器,同时关注高效、适配硬件的算法与计算内核。在加入 Kimi 之前,他曾在 Tilde Research 从事应用可解释性研究。需要注意的是,检索时这份主页仍保留着其在 Kimi 工作的介绍,任职状态应以最新离职声明为准。
从高中生到 AI 项目核心成员
据新华财经此前报道,陈广宇来自深圳,2026 年从惠州华润小径湾贝赛思国际学校高中毕业。其“17 岁研究者”的身份,在今年 3 月 Attention Residuals 论文发布后受到关注。
《深圳特区报》在当时的采访中记录了他的研究起点:通过阅读经典论文和追踪 GitHub 开源项目补足基础,随后在社交平台分享技术思考,引起一家硅谷 AI 初创公司负责人的注意。他通过限时实验测试后,获得了赴美实习的机会,并在当地工作了七周。
2025 年 11 月,他进入 Kimi 团队实习。
从其个人博客可以看到,他实际参与了这些项目的研究,而不是只有论文上的署名。
在 2025 年的技术文章中,他讨论过使用 Triton 实现矩阵乘法及 L2 缓存优化、使用 TileLang 实现 Flash Attention,以及 Triton Flash Attention 前向计算的实现。这些内容集中于一个具体问题:如何把数学上的算法,变成能够在 GPU 上高效执行的程序。
这些工作与他后面的研究方向一脉相承。模型架构决定计算如何组织,优化器影响训练如何更新参数,计算内核则决定这些操作在硬件上执行得有多快。从其公开项目看,他的兴趣横跨了这几个相互关联的层面。
陈广宇最受关注的成果,是 2026 年 3 月 16 日公开的 Attention Residuals (《注意力残差》)。他与张宇、苏剑林被标注为同等贡献的共同第一作者。
这项研究关注的是大模型内部不同层之间如何传递和利用信息。
在常见的 PreNorm Transformer 中,残差连接以固定权重累加各层输出。论文指出,随着网络加深,这种累加可能使隐藏状态的幅度不断增大,逐渐稀释单层贡献。Attention Residuals 的思路,是用跨层的 softmax 注意力替代固定累加,让模型通过可学习、与输入有关的权重,选择性地聚合前面各层的表示。
可以将其理解为:模型在经过许多层处理后,不再只能接收此前信息不断相加的结果,而是获得了一种重新选择和组合早期表示的机制。这里的“注意力”作用于模型深度方向,与通常讨论的不同 token 之间的注意力有所区别。
但让每一层访问此前所有层的输出,也会增加存储和通信负担。为此,团队进一步提出 Block AttnRes:把网络层划分成多个区块,区块内部保留普通残差累加,在区块之间进行注意力聚合,以降低额外开销。
《中国新闻周刊》在引用苏剑林的研究回顾时介绍,最初的想法及小规模实验由苏剑林提出,张宇和陈广宇随后参与更大规模验证,并共同提出了论文中的 Block Attention Residuals 设计。这个分工说明,陈广宇的重要贡献包括将初步方案推进到更适合大规模训练的形式。
论文在总参数 480 亿、激活参数 30 亿的 Kimi Linear 架构上进行了验证,预训练数据规模为 1.4 万亿 token。官方项目资料称,在其扩展规律实验中,Block AttnRes 可以达到需要多用 25% 计算量的基线模型的损失水平。这个结论对应特定实验条件,不应扩写为所有模型训练都能获得同等收益。
事实上,在参与 Attention Residuals 之前,陈广宇已经参与了 Tilde Research 的 MoMoE 项目。
Tilde 于 2025 年 7 月发布的《MoMoE: Memory-optimized Mixture of Experts》将 Nathan Chen 列为作者之一。他的个人博客也收录了这项工作。
MoMoE 处理的是混合专家模型的工程效率问题。MoE 通过每个 token 只调用部分专家降低活跃计算量,但实际实现仍可能受到不合理的数据布局、碎片化计算和中间张量存储等因素限制。MoMoE 使用融合 Triton 内核、优化内存布局,并提供可配置的反向传播方案,在计算与内存占用之间做取舍,重点面向模型训练和微调。
这项工作的价值在于,模型架构带来的理论优势,需要通过底层实现才能转化为实际吞吐和显存收益。它与陈广宇后来关注的硬件适配算法、计算内核方向具有连续性。
他还参与了优化器相关研究。Tilde 于 2025 年 10 月发布的《Gram-Space Manifold Muon》署名包括 Ben Keigwin、Dhruv Pai 和 Nathan Chen;其个人网站也列出了这项成果。相比泛泛地称其参与“模型研发”,这些可追溯的项目更具体地说明了他的研究范围。
此外,《中国新闻周刊》报道,他加入 Kimi 后较早参与的工作之一,是加速 KDA,即 Kimi Delta Attention 的计算内核。
这次离职消息传播过程中,也出现了有关百万美元工作邀约、退学和具体岗位的讨论。
几天前,投资人 Deedy Das 在 x 上曾分享过一位 17 岁年轻人获得多家实验室邀约的经历,Deedy 在 x 上写道:“今天遇到一个孩子,14 岁时英语不太好,却用大模型自学了人工智能,,在一家顶尖人工智能公司实习了一年,然后飞越半个地球去美国排名前十的大学读本科;两周后辍学;17 岁时就收到了旧金山顶尖新实验室的 5 份年薪 100 万美元以上的工作邀请。”
Deedy 同时感慨,传统教育已经彻底消亡了,现在的孩子们体质和以前不一样了。
网络讨论随后将其与陈广宇,认为这位投资人提到的天才少年就是陈广宇。
但这些都只是猜测,Deedy 后续并未透露他遇到的这位少年的真实姓名。
17 岁,陈广宇的研究生涯才刚刚开始。从阅读论文、编写计算内核,到参与大模型架构研究,他已经把好奇心变成了具体的成果。前往湾区之后,他还会遇到新的问题、伙伴和选择。
比下一站加入哪家公司更值得期待的,是这个年轻人接下来还会给行业带来什么新惊喜。对他而言,未来有足够的时间去探索,也有足够的空间让作品走在“天才”的标签前面。
参考链接:
🔥 热词:#Kimi核心架构细节